
Le Littératron ou la « machine à mot ». Une fiction pour penser l’innovation aujourd’hui
Résumé
Cet article 1 explore la portée heuristique d’un petit ouvrage de fiction publié en 1964 par Robert Escarpit, le Littératron, qui met en scène les instigateurs d’une innovation technique basée sur le traitement et la génération automatique du langage. Au-delà de sa trivialité, cette fiction offre une grille de lecture remarquablement actuelle pour interroger les stratégies discursives, les logiques financières et les rapports de pouvoir qui président au déploiement des innovations technologiques. Elle résonne en outre particulièrement avec l’actualité du monde digital, de la gouvernementalité algorithmique des plateformes d’intermédiation à l’irruption des grands modèles de langage qui semblent avoir fait entrer la « machine à mots » d’Escarpit dans notre réalité quotidienne.
Mots clés
Innovation sociotechnique, Robert Escarpit, intelligence artificielle, gouvernementalité, cybernétique, capitalisme de plateforme
In English
Title
Le Littératron, or the « Word Machine »: A Fiction for Thinking Innovation Today
Abstract
This article explores the heuristic value of a short work of fiction published in 1964 by Robert Escarpit, Le Littératron, which depicts the instigators of a technical innovation based on the automatic processing and generation of language. Beyond its triviality, this fiction offers a remarkably timely framework for examining the discursive strategies, financial logics, and power relations that govern the deployment of technological innovations. It resonates particularly with today’s digital landscape, from the algorithmic governmentality of intermediation platforms to the emergence of large language models, which seem to have brought Escarpit’s « word machine » into our everyday reality.
Keywords
Socio Technical innovation, Robert Escarpit, Artificial Intelligence, governmentality, cybernetic, platform capitalism
En Español
Título
El Littératron, o la « máquina de palabras »: una ficción para pensar la innovación hoy
Resumen
Este artículo explora el alcance heurístico de una breve obra de ficción publicada en 1964 por Robert Escarpit, Le Littératron, que pone en escena a los instigadores de una innovación técnica basada en el procesamiento y la generación automática del lenguaje. Más allá de su trivialidad, esta ficción ofrece un marco de lectura notablemente vigente para interrogar las estrategias discursivas, las lógicas financieras y las relaciones de poder que presiden el despliegue de las innovaciones tecnológicas. Resuena además de manera particular con la actualidad del mundo digital, desde la gubernamentalidad algorítmica de las plataformas de intermediación hasta la irrupción de los grandes modelos de lenguaje, que parecen haber convertido la « máquina de palabras » de Escarpit en una realidad cotidiana.
Palabras clave
Innovación sociotécnica, Robert Escarpit, inteligencia artificial, gubernamentalidad, cibernética, capitalismo de plataformas
Pour citer cet article, utiliser la référence suivante :
Pucheu David « Le Littératron ou la « machine à mot ». Une fiction pour penser l’innovation aujourd’hui », n°, 2026, p. à , consulté le mardi 20 octobre 2026, [en ligne] URL : https://lesenjeux.univ-grenoble-alpes.fr/2026/varia/le-litteratron-ou-la-machine-a-mot-une-fiction-pour-penser-linnovation-aujourdhui/
Le Littératron ou la “machine à mot”.
Une fiction pour penser l’innovation aujourd’hui
En 1964, Robert Escarpit, pionnier de la sociologie de la littérature et figure fondatrice des Sciences de l’Information et de la Communication en France, publie le Littératron 2, l’un de ses premiers écrits consacrés aux technologies de traitement de l’information numérique. Dans cette fiction aux accents anticipationnels, Escarpit met en scène les instigateurs d’une innovation technique basée sur le traitement automatique du langage : une « machine à mots » dotée de programmes capables de générer, à partir de ce qu’on appellerait aujourd’hui du machine learning, des contenus taillés sur mesure pour leurs récepteurs qu’ils soient citoyens, consommateurs, lecteurs ou apprenants.
Libérée des contraintes de la méthode scientifique, l’écriture du Littératron fut sans doute pour Escarpit l’occasion de livrer ses intuitions sur ces outils d’un nouveau genre dont les usages étaient encore à leur balbutiement en 1964. S’il ne fait nul doute qu’Escarpit avait eu vent des prévisions fantasmatiques qu’avaient formulées, presque une décennie auparavant, les pères fondateurs de l’Intelligence Artificielle lors du congrès de Dartmouth, on sait qu’il n’avait pas encore à l’époque de connaissances approfondies des machines à traiter l’information et des théories cybernétiques qui les avaient portées au grand jour. Selon son propre aveu, sa rencontre avec la théorie mathématique de l’information et plus largement avec la cybernétique date de 1968 à travers les travaux du physicien français Eli Roubine (Escarpit, 1992). Il faudra attendre la publication de sa Théorie générale de l’information, une décennie plus tard, pour qu’Escarpit développe sa critique de la « raison artificielle » et en fasse du même coup un objet de recherche central des Sciences de l’Information et de la Communication naissantes (voir « La famille Frankenstein » et « Le rêve cybernétique » dans Escarpit, 1976).
Mais avant d’être un roman de science-fiction écrit au présent (toute la narration se passe dans les années 1960), le Littératron est à classer dans la catégorie des romans picaresques dépeignant, à travers la vie d’un même protagoniste, la critique sociale d’un monde perçu de l’intérieur. En l’occurrence, Escarpit adresse ici une critique acerbe à l’endroit de l’idéologie technocratique de son temps. En interrogeant les chemins tortueux de l’innovation où se mêlent les enjeux de pouvoir politique, économique, militaire et scientifique, il y dresse un portrait sans concession des techno-prophètes pratiquant « l’esbroufe à la technologie », des politiciens démagogues, du « jeune patronat » adepte du brainstorming et des investisseurs aux dents longues.
Mais au-delà de sa trivialité, le Littératron constitue une fiction d’une saisissante actualité pour questionner les motifs imaginaires et idéologiques qui irriguent les innovations technologiques. Cette contribution voudrait précisément mettre en lumière l’actualité des idées proposées par le Littératron et, par certains aspects, la permanence de phénomènes propres au processus d’innovation tels qu’ils s’y trouvent dépeints.
Bien conscient des limites d’un tel exercice de réflexion rétrospective qui pourrait travestir les propos d’Escarpit, mon ambition consiste plus humblement à souligner la portée heuristique d’un ouvrage largement méconnu et dont les intuitions nous invitent à interroger l’actualité contemporaine de l’innovation technique en général et du monde numérique en particulier.
Nous nous intéresserons dans un premier temps aux chemins empruntés par le Littératron pour accéder au statut d’innovation. Loin de procéder des seules qualités de l’objet technique, son succès repose sur un ensemble de stratégies d’acteurs visant à mobiliser des réseaux, à capter l’attention des décideurs et à susciter l’adhésion des marchés et de l’opinion. À travers cette fiction, Escarpit donne à voir les mécanismes sociaux par lesquels se construisent et se diffusent les promesses attachées à l’innovation technologique.
Nous examinerons ensuite le rôle joué par le langage dans cette construction de la nouveauté. À partir de la « syllabe magique » -tron, dont Escarpit raille l’usage, nous interrogerons la fonction des déplacements sémantiques qui accompagnent les différentes vagues d’innovation technologique. Du cyber– au smart-, en passant par le 2.0 ou, plus récemment, le préfixe de-, ces marqueurs lexicaux ne se contentent pas de désigner la nouveauté : ils contribuent à la mettre en récit, à lui associer des imaginaires et à naturaliser les transformations sociales, économiques et politiques qu’elle engage.
Enfin, nous confronterons les usages imaginés du Littératron aux formes contemporaines du capitalisme numérique. L’« effet narcisse » du projet Boomerang, fondé sur la collecte des traces individuelles et leur réinjection sous la forme de contenus ajustés à leurs destinataires, entre singulièrement en résonance avec les mécanismes de profilage et de recommandation du capitalisme de plateforme. L’essor récent des intelligences artificielles génératives et plus particulièrement des Larges Modèles de Langage (LLM) prolonge cette actualité en donnant une matérialité nouvelle à cette « machine à mots », imaginée par Escarpit en 1964, capable d’automatiser la production du discours.
Les chemins tortueux de l’innovation
Des innovations d’opinion
La plus grande partie du Littératron ne traite pas tant des technologies que des discours qui les accompagnent et des stratégies d’acteurs qui président à leur diffusion. On retrouve en germe une certaine sociologie de l’innovation (Akrich, Callon, Latour, 1988) au sein de laquelle se joue le devenir toujours incertain des inventions techniques. Bien que centrée sur les stratégies d’un individu entrepreneur, l’histoire fictive du Littératron montre comment le processus d’innovation met en jeu des rapports de pouvoir au sein de réseaux d’acteurs aux intérêts divergents, animés par des controverses aux enjeux décisifs, tout en cherchant à s’attirer les faveurs du marché et de l’opinion publique.
À travers l’histoire du Littératron c’est l’innovation technologique de son temps qu’Escarpit entendait critiquer, plus particulièrement l’audiovisuel et les médias de masse qui concentraient alors tous les regards. Interrogé en 1992 par Anne Marie Laulan et Jean Devèze (Escarpit, 1992), Escarpit expliquait la genèse du Littératron à partir de sa lecture critique de Marshall McLuhan. Les écrits de l’universitaire canadien, qui jouissaient d’une grande popularité internationale dans les années 1960, avaient suggéré l’idée d’un changement civilisationnel inéluctable porté par la transition des médias écrits vers les médias audiovisuels. C’est précisément cette soi-disant inéluctabilité qu’Escarpit entendait critiquer en affirmant que de tels discours agissaient comme des prophéties auto réalisatrices, concentrant progressivement toute l’attention du public mais aussi des décideurs et des investisseurs sur la dite nouvelle « révolution » (Richaudeau, 1975, p 88).
Les écrits de McLuhan venaient d’une certaine manière renforcer les croyances alimentant ce que Dominique Boullier désigne comme des « innovations d’opinion ». Des innovations qui seraient moins basées sur leurs propriétés intrinsèques que sur un ensemble de croyances prospectives diffusées par leurs instigateurs afin d’exciter les marchés et de faire converger les capitaux vers l’objet de leur dévotion intéressée. Une mécanique devenue aujourd’hui centrale dans la financiarisation des innovations technologiques dont la valorisation symbolique anticipée précède, tout en la déterminant, la valorisation économique. Comme l’écrit Dominique Boullier,
« ces anticipations ne reposent sur rien d’autre que sur la perception des actions possibles des autres acteurs du marché financier (…) le marché financier est un producteur massif de croyances, impossibles à fonder dans d’autres critères que les perceptions réciproques » (Boullier, 2006, 29).
De l’aveu d’Escarpit lui-même, l’idée du Littératron a germé dans son esprit au début des années 1960 alors qu’il cherchait à financer ses propres projets de recherche scientifique dans les arcanes du pouvoir. Bien que le ministère de la recherche daignât lui octroyer quelques maigres financements, ce sont les « machins audiovisuels » (Escarpit, 1992), aux dires de la cheffe de cabinet de l’époque, qui ramassaient alors tous les suffrages. Même si les décideurs politiques n’y connaissaient pas grand-chose, il fallait répondre à l’injonction à la nouveauté dictée par les lobbyistes de l’innovation présumée. Comme pouvait l’affirmer un des protagonistes politiques dans une fameuse citation du Littératron : « L’audiovisuel ça paie. Les finances crachent, les commissions votent, les électeurs marchent. Ça les impressionne. Ils ne savent pas ce que c’est. Moi non plus » (Escarpit, 1964, 30).
Un progressisme conservateur
Le fait d’avoir choisi d’inscrire la narration du Littératron dans le présent des années 1960 et non dans un devenir proche ou lointain permet à Escarpit de se prémunir d’un écueil aussi fréquent dans la prospective technologique que dans l’anticipation science-fictionnelle : celui de projeter des scénarios d’usages détachés de leur contexte d’inscription sociohistorique. Pour accéder au statut d’innovation, le Littératron doit en effet composer avec les conventions du système économique et politique des années 1960 dans lequel il s’insère. Et c’est précisément ce qui garantissait, aux yeux de son instigateur, le succès du Littératron : il arrivait à point nommé pour parachever un système encore imparfait tout en lui conférant l’alibi de la nouveauté.
Toute la narration du Littératron s’articule autour de l’entreprise initiée par Mériadec Le Guern, jeune arriviste qui va s’engager dans une véritable croisade afin d’ériger le Littératron et par extension la litteratronique au sommet de l’innovation sociotechnique de son temps. Le Guern n’est ni un inventeur, ni un technicien, c’est avant tout un médiateur, un passeur d’idées, un « traducteur » et un homme de réseau animé par des ambitions personnelles. L’idée du Littératron a mûri dans la tête de Le Guern lors d’une conférence alors qu’il était interprète : le « congrès international de biocybernétique ». Lors de cette rencontre fictive où participe une élite de chercheurs et de décideurs de tous horizons, la jeune science cybernétique, ici fondamentalement entendue comme science du pilotage de l’action des systèmes indistinctement vivants et artificiels, semblait offrir d’incroyables opportunités applicatives. Du « tronc austère de la biocybernétique », s’enthousiasmait Le Guern :
« jaillissait toute une floraison de techniques ingénieuses permettant de gouverner, d’orienter, d’intoxiquer, de vider, de laver, de désinfecter, de rénover, d’activer, de débrancher, de déconnecter, de court-circuiter et de déphaser tant l’esprit des foules que celui des individus, pour le plus grand bien de l’ordre social existant » (Escarpit, 1964, p. 41).
La biocybernétique semblait offrir à celui qui saurait s’en emparer un puissant instrument de gouvernement des conduites individuelles et collectives pouvant être mis au service d’intérêts politiques et économiques aussi nombreux que contradictoires. Un pouvoir basé notamment sur les capacités prédictives des dispositifs cybernétiques, fondés sur les logiques probabilistes de la mécanique statistique, présageant cette catégorie particulière de biopouvoir qu’est la gouvernementalité algorithmique (Rouvroy, Berns, 2013). Consécutivement à cet épisode, Le Guern, fraîchement titulaire d’un doctorat de Lettres, découvre un article obscur cantonné dans une poussiéreuse bibliothèque universitaire portant sur le Traitement Automatique du Langage (TAL). C’est cet article qui va lui révéler toutes les potentialités des machines cybernétiques, exhibant des aptitudes manifestes à faire rentrer le langage dans le giron de la raison calculatoire et de l’automatisation.
Si Le Guern se montre particulièrement enthousiaste dans cette entreprise, c’est qu’à ses yeux, toutes les conditions semblaient réunies pour accueillir une telle innovation. Tout semblait en effet prêt pour la “machine à mots” : la production industrielle de la littérature, du langage et des discours à l’œuvre dans la culture de masse de l’après-guerre avait déjà enclenché le pas. La litteratronique promettait d’actualiser les logiques calculatoires imparfaites déjà inoculées dans la production industrielle de la culture, la communication politique, le marketing et la publicité… « Notre siècle attendait la machine à mots – s’écriait Le Guern – grâce à elle, la littérature, la pédagogie, l information, la politique deviendront des sciences enfin exactes » (Escarpit, 1964, p. 55).
Ce que montre avec perspicacité Escarpit, c’est que la tant vantée nouveauté des innovations technologiques dissimule bien souvent les réels motifs de leur adoption par les acteurs sociaux. Si les virtualités des innovations (ce qu’elles sont en puissance) offrent tous les signes d’une potentielle « révolution », elles ne peuvent se soustraire au système dans lequel elles s’insèrent et tendent bien souvent à en approfondir la téléologie. Pour reprendre la célèbre formule de l’Ecole des Mines : « adopter une innovation, c’est l’adapter » (Akrich, Callon, Latour, 1988, p. 14). À bien des égards, l’irruption des technologies numériques dans nos sociétés a contribué à asseoir un discours sur la disruption qui, tout en suscitant des espoirs de rénovation sociale dans le lointain de l’avenir, a poursuivi aveuglément la trajectoire du capitalisme de marché. Les plateformes numériques ont par exemple accompli la logique publicitaire jusqu’à son terme, substituant à la segmentation grossière des audiences de masse une granularité comportementale individuelle que le marketing du XXe siècle appelait de ses vœux sans jamais pouvoir la réaliser. De la même façon, la production et la recommandation algorithmique de contenus culturels par les plateformes prolonge et radicalise les logiques d’industrialisation de la culture identifiées dès 1944 par Adorno et Horkheimer : la standardisation des formats éditoriaux pilotée par les métriques d’engagement parachève, avec une efficience sans précédent, la rationalisation de la production culturelle que l’industrie de masse avait entamée au siècle dernier.
Ces continuités, que tendent à dissimuler les prétentions disruptives des innovations sociotechniques, sont également obscurcies par des stratégies rhétoriques qui accompagnent leur diffusion. Il s’agit là d’une piste de réflexion que le Littératron nous invite également à suivre à travers l’usage emphatique d’affixes dérivationnels, comme celui du suffixe -tron, qui tendent à réduire la complexité des phénomènes technologiques à un signifiant unique, opérant comme un condensé idéologique capable de susciter l’adhésion des marchés, des décideurs et de l’opinion publique.
Les affixes de l’innovation digitale
Le monde cyber
Pour installer durablement une innovation d’opinion dans l’imaginaire collectif, encore faut il marquer les esprits au-delà de la simple démonstration technique. Escarpit consacre de longs développements aux stratégies rhétoriques qui ont conduit Le Guern à baptiser son invention Littératron, contraction de littérature et électronique. Le suffixe –tron permettait d’affubler à un quelconque objet ou phénomène la connotation d’une innovation, suggérant à la fois une mystérieuse et vague technicité (basée sur l’électronique) et le re-nouveau de l’objet ou du phénomène en question (ici l’écriture) désormais surdéterminé par cette même technicité. C’est grâce aux conseils d’un potentiel financeur que Le Guern opta pour cette « syllabe magique » qui devait devenir, pour lui, « le sésame du succès » : « de tous les suffixes mon ami, le meilleur c est –tron. Cyclotron, betatron, positron… Vous voyez ce que je veux dire… Avec un –tron bien placé, vous raflez des millions et vous avez toutes les priorités… Avec un nom comme ça tous les robinets sont ouverts » (Escarpit, 1964, p. 31). Si Escarpit entendait ici critiquer la rhétorique des innovateurs, il n’en reste pas moins vrai que ces affixes dérivationnels, comme les nomment les linguistes, n’ont jamais cessé d’alimenter la vulgate des innovations technologiques. On peut donc légitimement s’interroger, comme le fait Escarpit, sur le sens et les fonctions de ces affixes qui accompagnent le déploiement des innovations.
Associé aux imaginaires du « village global » et aux métaphores organicistes d’un système nerveux planétaire suggéré par le déploiement des technologies électroniques (basées sur le déplacement des électrons) et des réseaux de télécommunication (radio, télévision, satellites etc.), le suffixe –tron, comme le préfixe télé- avant lui, jouissaient d’une grande popularité depuis l’après-guerre. Avec le développement de l’informatique personnelle et des technologies numériques, c’est bientôt le préfixe cyber- qui va saturer l’espace discursif pour caractériser la nature innovante des objets et des phénomènes impactés par le traitement automatique de l’information autorisé par les ordinateurs et leur mise en réseau. Le préfixe cyber- témoignait originellement de l’influence des imaginaires cybernétiques dans le cercle restreint des pionniers du numérique, informés par la science du même nom (Wiener, 1952) et son pendant littéraire, le cyberpunk.
Courant science-fictionnel qui accompagne l’émergence du nouveau monde numérique dans la Silicon Valley des années 1980, le cyberpunk en viendra même à servir de bannière de ralliement aux communautés techno-futuristes et hackers californiennes, autoproclamées cyberpunk (Jude, Sirius, Nagel, 1995 ; Elmer-Dewitt, 1993). Le cyberpunk et plus largement la cyberfiction américaine vont durablement informer l’imaginaire de l’informatique en réseau à travers notamment le concept de cyberespace forgé par William Gibson en 1984. Cette conception territoriale des mondes virtuels qu’on retrouve également dans les cyberfictions de Vernor Vinge (The Other Plan) ou de Neil Stephenson (metaverse) envisage Internet comme un espace immatériel d’interactions désincarnées, à la fois promesse d’émancipation individuelle et nouveau territoire de contrôle social (Barlow, 1996). Le préfixe cyber- témoigne ainsi de la réception ambivalente de la cybernétique où s’articulent d’un côté l’utopie d’un individu connecté et autonome, affranchi des médiations institutionnelles voire de toute forme d’hétéronomie ; et de l’autre, l’intuition dystopique d’un monde réticulaire où le contrôle peut s’exercer non plus par la contrainte directe mais par l’architecture même des systèmes d’information, ce que Deleuze identifiait dès 1990 comme le passage des sociétés disciplinaires aux sociétés de contrôle. Ce préfixe deviendra omniprésent avec la démocratisation de l’informatique personnelle en réseau au tournant des années 1990 pour bientôt s’adosser à tous les objets, processus ou phénomènes affectés de près ou de loin par les technologies numériques en réseau (cyberculture, cybernation, cybersociété, cybercitoyen pour n’en citer que quelques-uns…).
Au milieu des années 2000, l’épithète 2.0 va littéralement supplanter le préfixe cyber- pour caractériser les vertus émancipatrices du nouveau « logiciel collaboratif » (« 2.0 » suggérant la métaphore d’une nouvelle version logicielle) dont disposaient désormais les sociétés humaines dans un contexte de massification des usages. C’est ce basculement dont peut témoigner l’analyse comparative des occurrences des termes « cybereconomy » et « Web 2.0 » entre 1990 et le début des années 2010 dans le vaste corpus anglophone numérisé par Google (figure 1). Sous l’impulsion du haut-débit, de la baisse des coûts matériels et de la diffusion massive de l’informatique mobile, le web dit « participatif » ou «web plateforme» a vu converger en son sein une part croissante de la population mondiale, convertissant les internautes en autoproducteurs permanents de contenus et conférant une matérialité inédite au vieux fantasme d’une intelligence collective planétaire.
Le monde 2.0 et ses avatars
Les célèbres conférences du consultant américain Tim O’reilly « What is web 2.0 ? » (O’Reilly, 2005), qui ont contribué à en forger l’expression, avaient également pour finalité de racheter la « nouvelle économie » aux yeux d’une opinion publique passablement désabusée après l’éclatement de la bulle spéculative d’Internet à l’aube des années 2000 (Bouquillion, Matthews, 2010). Si l’économie numérique ne semblait pas tenir ses promesses, la persistance de certains services basés sur des logiques collaboratives et contributives des plateformes, à l’image de Wikipédia, Google, Amazon, des blogs ou des premiers réseaux sociaux, offrait à O’Reilly et à ses épigones les matériaux empiriques nécessaires à la formulation d’un récit de refondation. À la cybersociété, fondée sur l’ambivalence entre émancipation individuelle et asservissement aux logiques étatiques ou industrielles, succédait une « société 2.0 » censée libérer les utilisateurs des médiateurs et des institutions traditionnelles en redistribuant le pouvoir au sein de réseaux horizontaux, participatifs et autorégulés, où l’intelligence collective devait garantir une forme inédite, plus ouverte et vertueuse, de coordination sociale.
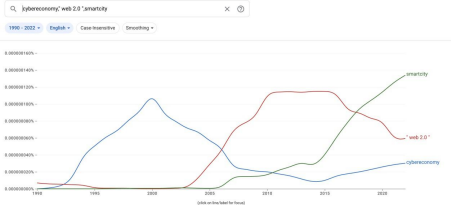
Figure 1 : Comparaison des occurrences des termes « cybereconomy », « Web 2.0 » et « smart city » entre 1990 et 2022 dans le corpus anglophone du Google Ngram Viewer.
Mais le succès planétaire de cette épithète visant à qualifier une rupture dans l’ordre des médiations sociales et économiques a été l’alibi d’une idéologie de la participation aujourd’hui largement affaiblie par ses contradictions internes (Rebillard, 2011). L’exploitation outrancière des données générées par les utilisateurs, opérée par une poignée d’acteurs de l’intermédiation, a donné lieu à d’importantes critiques aujourd’hui largement véhiculées (Srnicek, 2018 ; Zuboff, 2018). Apparemment plus neutre, le préfixe crowd (la foule) corrélatif du Web 2.0 (crowdsourcing, crowdworking, crowdfunding…) n’en reste pas moins le véhicule d’une idéologie politique façonnée par l’imaginaire libéral nord-américain qui, tout en consacrant les vertus de la « sagesse des foules » (Surowiecki, 2004), a fait du recours à la foule un moteur décisif d’accumulation du capitalisme de plateforme (Scholz, 2013 ; Casilli, 2019) ou du plus vaste processus de capitalisation de la vie numérique opérée par les industriels de la donnée (Stiegler, 2015).
Loin de disparaître, le préfixe cyber- s’est progressivement déplacé du centre vers la périphérie, pour ne pas dire la marge, et sert essentiellement à caractériser les dimensions sombres des TIC, sans doute en raison de sa filiation avec les dystopies cyberpunk et l’univers plus que jamais actif du piratage informatique (cybersécurité, cyberattaque, cybercrime, cyberharcèlement…).
Au début des années 2010, un autre préfixe faisait son entrée dans l’espace discursif des innovations sociotechniques pour qualifier cette fois la nature intelligente des dispositifs, objets et choses « augmentés » de capacités computationnelles : le préfixe smart- (smartphone, smartwatch, smartcity…). D’abord confiné dans le cercle des ingénieurs pour qualifier l’émergence d’une informatique post-PC (smartifact, smart-sensors, smart-grid) associée au projet de l’informatique « ubiquitaire » et à l’Internet des Objets (Pucheu, 2014), on retrouve le préfixe smart- partout où s’insinue la puissance calculatoire distribuée en réseau (Siegele, 2010). Une fois encore ce préfixe n’est pas neutre et accompagne les innovations autorisées par le stockage des données massives et leur traitement délocalisé dans des fermes de serveurs, les Big Data qui ont saturé le paysage médiatique au cours des années 2010.
L’inflation du préfixe smart-, comme peut le suggérer la popularité du terme smartcity à partir des années 2010 (figure 1), contribue à accréditer l’idée d’une progressive automaticité généralisée où les objets, les environnements et les processus traversés par les flux de données (data driven) se trouveraient progressivement dotés d’une forme d’autonomie décisionnelle. Cette sorte d’animisme informationnel, exploitant les propensions anthropomorphiques des utilisateurs pour naturaliser un ordre technique invisibilisé, dissimule pourtant des concepteurs humains pétris d’intentions (souvent contradictoires avec celles des utilisateurs) et des infrastructures sociotechniques (fermes de serveurs, data centers, travailleurs du clics…) aux dimensions industrielles qui en assurent l’opérationnalité. Des infrastructures qui se trouvent encore dissimulées derrière la puissance évocatrice du cloud computing (informatique en nuage) dont la nature n’a pourtant jamais été aussi matérielle et énergivore (Crawford, 2022).
Plus récemment, la lente émergence des innovations associées aux dispositifs cryptographiques en réseau des blockchains dessine elle aussi une nouvelle narration autour du concept de Web 3 qui viendrait racheter les dérives panoptiques du capitalisme de plateforme. Le préfixe de– (pour décentralisation, dérégulation ou désintermédiation) qui irrigue l’écosystème du Web3 (DeFi, DePin, DeSci, DeGov…) réactive les utopies décentralisatrices et libertariennes des origines d’Internet (Pucheu, 2023, 2024) dissimulant, derrière la rhétorique de l’émancipation individuelle, les formes de concentration et d’asymétrie de pouvoir qui s’y reconstituent (Baldwin, 2018 ; Matthews, 2026).
On voit bien comment ces affixes procèdent, à l’instar du suffixe -tron interrogé par Escarpit, d’une réduction idéologique délibérément opérée par les entrepreneurs-innovateurs. La célèbre revue Wired, principal organe de presse de la Silicon Valley depuis sa création en 1993, a constitué, et continue de constituer, l’un des principaux vecteurs de ces déplacements sémantiques, accompagnant chaque vague d’innovation de sa propre vulgate: du cyberespace libertarien des années 1990 au Web 2.0, des promesses du crowdsourcing à celles de la « smartification », le magazine a systématiquement contribué à forger et à populariser le lexique à travers lequel chaque époque se représente sa propre modernité numérique (voire par exemple : Barlow, 1996 ; Anderson, 2004, 2008 ; Single, 2005 ; Sterling, 2010).
S’ils relèvent pour une bonne part de stratégies marketing, ces déplacements sémantiques témoignent également des imaginaires et des idéologies qui irriguent les innovations technologiques. Ils tendent tous d’une manière ou d’une autre à susciter l’idée d’un déterminisme technologique sur les objets ou phénomènes qu’ils cherchent à caractériser, tout en dissimulant des réalités sociotechniques plus prosaïques : l’extraction et l’expropriation massive de données, l’exploitation d’un travail humain invisibilisé, la concentration capitalistique d’infrastructures computationnelles entre les mains de quelques acteurs hégémoniques, ou encore le coût énergétique et matériel d’une industrie se présentant volontiers comme immatérielle. En cela, ces affixes fonctionnent comme des opérateurs de naturalisation : ils transforment des choix industriels, économiques et politiques en propriétés intrinsèques de la technique, soustraits de facto à la délibération collective. Ainsi, derrière la « syllabe magique » -tron se dessine une machine dont les usages imaginés par Escarpit mettent déjà en jeu la collecte de données, la modélisation des comportements humains et la production automatisée de contenus destinés à orienter les conduites.
Actualité du Littératron
Le projet Boomerang et l’effet narcisse
Parmi les applications de la littératronique imaginées par Escarpit, un scénario d’usage résonne particulièrement avec l’actualité des technologies digitales : le projet boomerang. Ce projet, dont le « ministère de la persuasion constituait pour Le Guern le terrain d incubation privilégié » (Escarpit, 1964, p. 105), avait pour finalité de tester l’efficacité du Littératron en matière de gouvernabilité des consciences individuelles et collectives.
« Il reposait sur une hypothèse de travail, à savoir que l’image qu’il se fait de lui même est pour chaque homme l’étalon de toute valeur. Il s’ensuit que, consciemment ou inconsciemment, on n’aime d’autres œuvres que celles où on se reconnaît tel qu’on croit se connaître et que l’on ne se laisse persuader par des paroles que si l’on retrouve l’écho de ce qu’on pense avoir dit ». (1964, p. 125)
C’est dans la ville fictive de Pédouillac que Le Guern va mettre à l’épreuve cette hypothèse aussi qualifiée par son instigateur « d’effet narcisse ». Pendant plus d’une semaine, des enquêteurs « munis de petits magnétophones à transistors discrets et maniables, enregistrèrent des conversations de pédouillacais selon un plan rigoureux » (1964, p. 128). Ces données, récoltées à l’insu des habitants de Pédouillac, une fois codées et transférées sur des cartes perforées, étaient traitées par le Littératron afin d’en extraire des modèles (fondés sur la statistique et les règles formelles du langage) servant de base à la génération automatique de discours, de tracts publicitaires et d’affiches. D’abord dubitatif quant aux résultats escomptés, le projet sera finalement couronné de succès, ralliant l’ensemble de la population pédouillacaise derrière la campagne électorale d’un candidat épouvantail répétant mécaniquement les discours et propositions générés par le Littératron. L’efficacité de « l’effet narcisse » était ainsi démontrée :
« Les propres pensées profondes du sujet lui étant réinjectées provoquent dans les neurones des centres supérieurs le déclenchement d’oscillations hypnogéniques et euphorisantes. En un mot sans avoir conscience de se reconnaître dans ce qu’on lui lit ou ce qu’on entend, on se trouve plongé dans un état de béatitude réceptive qui élimine provisoirement le sens critique ». (1964, p. 142)
À travers ce projet boomerang, Escarpit met en lumière une stratégie qui demeure aujourd’hui encore centrale des modèles d’affaire du capitalisme digital. Pour maximiser le nombre d’utilisateurs ainsi que la qualité de leur engagement à leur service (attention, temps d’exposition, rendement productif de données), les plateformes d’intermédiation filtrent, acheminent et produisent les flux informationnels à partir du profilage comportemental des internautes. En fait, la grande majorité des services qui ont colonisé Internet ces 20 dernières années fondent leurs stratégies algorithmiques sur cet « effet narcisse » autorisé par la surveillance et le monitoring constant du comportement des utilisateurs.
Le principe opératoire de ces services repose sur une inférence permanente de nos intentions afin d’anticiper, en toute probabilité statistique, ce que nous désirons penser, voir, entendre, imaginer, écouter, consommer… En un mot, les algorithmes du machine learning façonnent un monde à notre image qui entretient, par un mécanisme de stimulation et de rétroaction permanente, cette « béatitude réceptive » évoquée par Escarpit. Chaque comportement nourrit le modèle qui nourrit en retour l’engagement, enfermant l’utilisateur dans une circularité narcissique dont l’efficacité repose précisément sur son invisibilité. Pris dans le jeu de miroirs des « chambres d’écho », les utilisateurs se conforment, sans nécessairement en avoir conscience, aux comportements prescrits non seulement par les concepteurs de ces dispositifs mais aussi par les acteurs qui en instrumentalisent les mécanismes pour orienter les conduites à leur profit.
Les travaux du célèbre chercheur de l’Université de Stanford B. J. Fogg sur le « design persuasif » (Fogg, 2003), à mi-chemin entre la psychologie comportementaliste et l’ingénierie informatique, et qui ont influencé toute une génération d’entrepreneurs de la Silicon Valley (Williams, 2018), incarnent aujourd’hui ce « ministère de la persuasion » imaginé par Escarpit et déterminé à gouverner les conduites individuelles et collectives sur la seule base des mécaniques comportementales (Harmand, Pucheu, 2019).
Mais la prescience d’Escarpit paraît moins surprenante si on la rapporte au climat intellectuel de son époque. La psychologie comportementaliste, la cybernétique et les sciences cognitives qui se structurent outre-Atlantique dans les années 1950-1960, partageaient déjà l’ambition de faire de l’analyse du comportement humain une science positive, susceptible de prédiction et d’intervention. Et force est d’admettre que le comportementalisme poursuit aujourd’hui silencieusement sa quête de positivité dans une bonne partie des sciences cognitives et des neurosciences mises au service de la modélisation computationnelle des comportements humains, à l’image des travaux du Human dynamic lab du MIT dirigé par le thuriféraire des Big Data, Alex Pentland (Pucheu, 2016).
Escarpit ne pouvait en revanche pas imaginer, à une époque où les ordinateurs demeuraient l’apanage des États et des grandes organisations, que l’explosion de l’informatique personnelle en réseau porterait bientôt cet « effet narcisse » à une échelle planétaire, articulant dans un même dispositif le profilage intime de milliards d’individus à des infrastructures industrielles aux dimensions mondiales.
La machine à mot : une fiction devenue réalité ?
Si les usages du Littératron envisagés par Escarpit en 1964 trouvent un écho particulier dans les modèles d’affaires du capitalisme de plateforme, la récente diffusion publique des Intelligences Artificielles basées sur les larges modèles de langage (LLM pour Large Language Model), semble avoir fait entrer la fiction du Littératron dans notre réalité quotidienne.
Que sont les LLM sinon des sortes de Littératron fondées sur l’extraction, l’analyse et le traitement de données autorisant la production automatisée du langage (écrit, visuel ou audio) ? Les techniques du machine learning et du traitement automatique du langage, utilisées en interne par les géants du Web depuis bientôt deux décennies (à des fins de profilage, analyse de sentiment, recommandation, prédiction…), ont trouvé dans les LLM leur expression la plus aboutie. Articulées aux machines d’inférence statistique des réseaux de neurones profonds (deep learning), les performances des grands modèles de langage ont été rendues possibles par l’exploitation massive des volumes de données et de contenus générés par les utilisateurs du web plateforme depuis le milieu des années 2000 (Bender, Gebru, McMillan-Major, & Shmitchell, 2021).
En l’espace de deux décennies, les plateformes numériques ont engendré un volume de traces textuelles, visuelles et sonores sans précédent dans l’histoire humaine. Un corpus planétaire produit, formaté et archivé dans des conditions idéales pour l’entraînement de modèles statistiques. Les contraintes de lisibilité machinique imposées par les moteurs d’indexation, les formats normalisés des réseaux sociaux et les logiques du marketing de contenu ont progressivement façonné une écriture industrialisée et calibrée pour le traitement automatique. Si l’industrialisation des contenus informationnels et culturels, comme l’affirmait déjà Escarpit à son époque, avait enclenché le pas au Littératron, que dire du monde d’aujourd’hui où la production industrielle du langage ne s’est jamais aussi bien prêtée à sa rationalisation mathématique ? C’est peut-être notre siècle et non celui d’Escarpit, « qui attendait la machine à mots »…
Si l’expropriation et l’exploitation des contenus générés par les utilisateurs des plateformes numériques constituait déjà une forme de prolétarisation de la pensée et de la créativité humaine (Couldry, Mejias, 2019), les IA génératives poussent cette logique à son paroxysme. En entraînant leurs modèles sur les productions cognitives et créatives de milliards d’individus, sans consentement, sans attribution et sans contrepartie, elles achèvent de transformer le travail intellectuel humain en matière première d’un processus d’accumulation dont les créateurs originaux se trouvent intégralement dépossédés.
L’une des applications phares du Littératron imaginée par Escarpit consistait ainsi à produire et générer des best-sellers sur la base d’une analyse statistique « rigoureuse des succès de librairie de la saison précédente » permettant de « déterminer le titre et le scénario du futur best-seller » (Escarpit, 1964, p. 159). Ainsi serait-il possible d’opérer la « génération de quatre pattern de best seller et de déterminer leur volume de tirage » (Ibid., p. 159). Cette ambition, qui pouvait paraître fantasque en 1964, décrit pourtant avec précision les méthodes qui président aujourd’hui à la production de contenus sur les grandes plateformes numériques. Les algorithmes du machine learning ne se contentent cependant plus de piloter la création, la production ou la consommation humaines ; de prescrire quoi produire, quoi regarder, quoi écouter. Les IA génératives sont désormais en mesure de produire elles-mêmes, intégralement et à une échelle sans précédent, les textes, les images, les vidéos et les chansons que leurs modèles statistiques ont appris à imiter. Elles augurent ainsi une accumulation sans commune mesure de contenus produits artificiellement, menaçant de saturer les canaux de diffusion d’un slop générique (littéralement : “bouillie”) qui dilue la visibilité et la valeur économique des créations humaines.
Comme dans le Littératron encore, les IA génératives laissent entrevoir l’émergence d’une propagande d’un genre nouveau, que des chercheurs ont récemment qualifiée de slopaganda (Klincewicz, Alfano, Fard, 2025), contraction de slop et de propagande. À la différence de la propagande traditionnelle, contrainte par les coûts de production et les canaux de diffusion centralisés, la slopaganda exploite la capacité des modèles génératifs à produire, à un coût quasi nul et à une vitesse sans précédent, des volumes illimités de contenus personnalisés, calibrés sur les biais cognitifs de leurs destinataires. Le projet boomerang d’Escarpit, avec ses enquêteurs munis de magnétophones et ses cartes perforées, préfigurait artisanalement ce que les algorithmes réalisent désormais à l’échelle planétaire : un gouvernement des opinions fondé sur la réinjection automatisée de nos propres dispositions, où l’effet narcisse se mue en instrument de manipulation politique.
Conclusion
Relire le Littératron plus de cinquante ans après sa publication, c’est plonger dans l’univers des années 1960 où se sont agrégées les couches sédimentaires de notre “monde numérique”. La littératronique imaginée par Escarpit s’inscrit d’abord dans l’horizon des processus de production industrielle de la culture de masse enclenchés dans la première moitié du XXe siècle, et à partir desquels se sont accélérées les logiques de standardisation, de rationalisation du langage et de la créativité humaine. L’émergence du traitement automatisé de l’information, soutenue par la jeune science cybernétique (Wiener, 1952) et ses perspectives d’ingénierie sociale a concouru à faire entrer ces logiques de rationalisation dans le champ de l’automatisation. Directe émanation de la cybernétique, l’utopie du projet de création d’une Intelligence Artificielle, enclenché dès 1956, en constitue sans aucun doute le prolongement le plus ambitieux.
Autant de strates que le Littératron met en fiction avec une prescience remarquable, et dont la convergence avec les dispositifs algorithmiques contemporains confère à cette œuvre une actualité saisissante. Mais au-delà de cette résonance thématique, c’est la portée heuristique du roman comme grille d’analyse du processus d’innovation qui mérite d’être soulignée. En situant délibérément sa narration dans le présent de son époque, Escarpit nous rappelle que toute innovation s’inscrit dans un système de rapports de pouvoir préexistants qu’elle tend à prolonger plutôt qu’à subvertir. En donnant à voir les stratégies rhétoriques, les logiques financières et actorielles qui président au déploiement du Littératron, il esquisse une sociologie de l’innovation dont les ressorts demeurent opératoires pour analyser chaque nouvelle vague de disruption proclamée.
Le Littératron nous invite à renverser les questionnements naïfs sous-tendus par les idéologies du déterminisme technologique qui dissimulent les rapports et les enjeux de pouvoir constitutifs des innovations sociotechniques. Plutôt que de nous demander ce que les intelligences artificielles « font » à la société et à la culture, il est urgent de nous préoccuper de ce que font, et entendent faire, les acteurs sociaux et économiques qui pilotent ces innovations au bénéfice de leurs intérêts financiers, géopolitiques et de leur agenda idéologique (Pucheu, 2025). C’est cette portée critique qu’Escarpit mobilisait, avec les armes de la fiction picaresque, contre l’idéologie technocratique de son temps. Cette question n’a rien perdu de sa pertinence.
Notes
[1] Cet article est issu d’une communication proposée en 2018 dans le cadre du colloque international « Robert Escarpit, le centenaire d’un pionnier » (20 et 21 sept. 2018), Archives Municipales de Bordeaux, organisé par le laboratoire MICA de l’Université Bordeaux Montaigne.
[2] On distinguera ici par l’italique le Littératron comme œuvre du Littératron (sans italique) comme objet technologique fictif
Références bibliographiques
Akrich, Madeleine ; Callon, Michel ; Latour, Bruno (1988), « À quoi tient le succès des innovations ? Partie II : Le choix des porte-paroles », Gérer et comprendre, n° 12, p. 14-29.
Anderson, Chris (octobre 2004), « The Long Tail », Wired, vol. 13, n°10.
Anderson, Chris (juin 2008), « The End of Theory: The Data Deluge Makes the Scientific Method Obsolete », Wired, vol. 16, no 7.
Baldwin, Joe. 2018, « In Digital We Trust: Bitcoin Discourse, Digital Currencies, and Decentralized Network Fetishism », Palgrave Communications, vol. 14, n°4.
Barlow, John Perry (juin 1996), « Declaring Independence », Wired, vol. 4, n°6.
Bender, Emily M. ; Gebru, Timnit ; McMillan-Major, Angelina ; Shmitchell, Shmargaret (2021), « On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? », Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, p. 610-623.
Boullier, Dominique (2006), « Capitalisme financier, innovation d’opinion et conventions socio-cognitives », Quaderni, n°60, p. 25-34.
Bouquillion, Philippe ; Matthews, Jacob T. (2010), Le Web collaboratif. Mutations des industries de la culture et de la communication, Grenoble : Presses universitaires de Grenoble.
Casilli, Antonio A. (2019), En attendant les robots. Enquête sur le travail du clic, Paris : Seuil. Couldry, Nick ; Mejias, Ulises A. (2019), The Costs of Connection: How Data Is Colonizing Human Life and Appropriating It for Capitalism, Stanford : Stanford University Press.
Crawford, Kate (2022), Contre-atlas de l’intelligence artificielle. Les coûts politiques, sociaux et environnementaux de l’IA, Paris : Zulma.
Elmer-DeWitt, Philip (février 1993), « Cyberpunk! », Time, vol. 141, n°6. Escarpit, Robert (1964), Le Littératron, Paris : Flammarion.
Escarpit, Robert (1976), Théorie générale de l’information et de la communication, Paris : Hachette.
Escarpit, Robert (1992), Entretiens avec Jean Devèze et Anne-Marie Laulan, SFSIC, [en ligne], http://palimpsestes.fr/communication/escarpit2.htm
Fogg, B. J. (2003), Persuasive Technology: Using Computers to Change What We Think and Do, Amsterdam : Morgan Kaufmann.
Howe, Jeff (juin 2006), « The Rise of Crowdsourcing », Wired, vol. 14, n°6.
Jude, St. ; Sirius, R. U. ; Nagel, Bart (1995), Cyberpunk Handbook: The Real Cyberpunk Fakebook, New York : Random House.
Klincewicz, Michał ; Alfano, Mark ; Fard, Amir Ebrahimi (2025), « Slopaganda: The Interaction between Propaganda and Generative AI », Filosofiska Notiser, vol. 12, n°1.
Matthews, Jacob T. (2026), Devalue. Blockchain Contradictions and the Politics of Value, Bingley : Emerald Publishing Limited.
O’Reilly, Tim (2005), « What is Web 2.0 ? Design Patterns and Business Models for the Next Generation of Software », [en ligne], http://www.oreilly.com
Pucheu, David (2014), « L’altérité à l’épreuve de l’ubiquité informationnelle », Hermès, n° 68, p. 115-122.
Pucheu, David (2016), « Social Big Data. Le fantasme d’une nouvelle physique sociale », Études digitales, vol. 2, n° 2, p. 89-106.
Pucheu, David (2023), « L’argent liquide digital. Le futur antérieur des crypto-monnaies ? », Réseaux, n° 238-239, p. 45-74.
Pucheu, David (2024), « Network, Cryptography, and the Next World to Come: An Everlasting American Techno-Millenarianism? », Zygon: Journal of Religion and Science, vol. 59, n° 1.
Pucheu, David (2026), « L’apocalypse techno-réactionnaire », La Pensée, vol. 426, n° 2, p. 56-77.
Rebillard, F. (2011). « Du Web 2.0 au Web2 : fortunes et infortunes des discours d’accompagnement des réseaux socionumériques », Hermès, n°59, p. 25-30.
Richaudeau, François (1975), « Marshall McLuhan ou Robert Escarpit ? L’avenir du livre », Communication & Langages, n° 27, p. 78-91.
Rouvroy, Antoinette ; Berns, Thomas (2013), « Gouvernementalité algorithmique et perspectives d’émancipation. Le disparate comme condition d’individuation par la relation?», Réseaux, vol. 1, n° 177.
Scholz, Trebor (2013), (dir.), Digital Labor : The Internet as Playground and Factory, New York : Routledge.
Siegele, Ludwig (2010), « It’s a Smart World : A Special Report on Smart Systems », The Economist, vol. 397, n° 8707, p. 1–20.
Singel, Ryan (octobre 2005), « Are You Ready for Web 2.0? », Wired, vol. 13, n° 10.
Srnicek, Nick (2018), Capitalisme de plateforme. L’hégémonie de l’économie numérique, Montréal : Lux.
Sterling, Bruce (août 2010), « Collaborative Consumption », Wired UK. Stiegler, Bernard (2015), La société automatique. 1. L’avenir du travail, Paris : Fayard.
Surowiecki, James (2004), The Wisdom of Crowds: Why the Many Are Smarter than the Few and How Collective Wisdom Shapes Business, Economics, Society and Nations, New York : Doubleday.
Wiener, Norbert (1952), Cybernétique et société. L’usage humain des êtres humains, Paris: Deux-Rives.
Williams, James (2018), Stand Out of Our Light: Freedom and Resistance in the Attention Economy, Cambridge University Press.
Zuboff, Shoshana (2019), L’Âge du capitalisme de surveillance, Paris : Zulm
Auteur
David Pucheu
david.pucheu@u-bordeaux-montaigne.fr